
Unha nova investigación no marco do Proxecto Nós e ALIA presente no principal foro científico internacional sobre procesamento da linguaxe natural
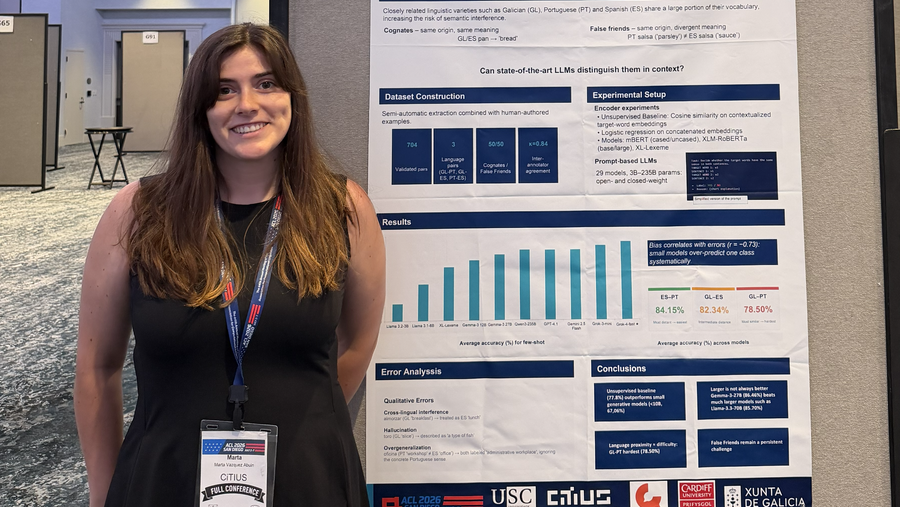
Un novo traballo vén de consolidar a presenza do Proxecto Nós nos principais foros de referencia científica global no eido das tecnoloxías lingüísticas. A investigación, liderada desde o centro, foi presentada recentemente na cidade de San Diego (EEUU) ao longo do congreso científico ACL 2026, a 64ª edición do encontro científico anual celebrado pola Asociación de Lingüística Computacional.
O artigo, titulado False Friends or Cognates? A Cross-lingual Semantic Ambiguity Evaluation for Galician, Portuguese and Spanish, foi defendido en formato póster pola investigadora predoutoral Marta Vázquez Abuín, e nel participan tamén os investigadores José Camacho-Collados, da Cardiff University, e Marcos García, membro do equipo Nós e investigador vinculado do CiTIUS. A investigación analiza a capacidade dos modelos de intelixencia artificial para interpretar correctamente palabras de aparencia similar entre galego, portugués e español, un desafío que continúa a presentar importantes dificultades mesmo para os sistemas máis avanzados.
O foro científico máis relevante da área
A ACL (Association for Computational Linguistics) é a principal sociedade científica internacional dedicada ao procesamento da linguaxe natural e á lingüística computacional. A súa reunión anual, ACL 2026, constitúe un dos principais foros internacionais para a presentación de novos avances científicos do ámbito, e nela coinciden cada ano equipos de investigación de universidades e centros de investigación de todo o mundo.
A aceptación dun artigo neste congreso evidencia a calidade científica da investigación desenvolvida no marco do Proxecto Nós e ALIA, poñendo en valor a capacidade do centro para superar un esixente proceso de revisión científica por pares.
'Cognatos' e 'falsos amigos': que son?
O traballo céntrase nun problema aparentemente sinxelo, pero especialmente complexo para a intelixencia artificial: distinguir cando dúas palabras moi similares en linguas diferentes significan realmente o mesmo, e cando esa semellanza resulta enganosa.
Na lingüística, os cognatos son palabras de diferentes linguas que teñen unha orixe común e presentan unha forma e un significado iguais ou moi próximos. É o caso de universidade (galego), universidade (portugués) e universidad (castelán), que designan o mesmo concepto. Os falsos amigos, en cambio, tamén se parecen na súa forma, pero teñen significados distintos. Por exemplo, esquisito en portugués significa raro ou estraño, mentres que en español a palabra exquisito denota algo refinado ou excelente. Este tipo de coincidencias poden inducir a erros tanto ás persoas como aos sistemas automáticos de procesamento da linguaxe.
«Os cognatos son palabras de linguas distintas que comparten orixe e manteñen un significado equivalente. Os falsos amigos, en cambio, escríbense ou soan de forma moi similar, pero significan cousas diferentes. Se para as persoas isto pode provocar confusión, no caso dos modelos de linguaxe a dificultade é maior, e aí está precisamente o reto», explica Marta Vázquez Abuin.
Para desenvolver o estudo, o equipo creou seis conxuntos de datos bilingües, elaborados ben de forma manual, ou ben mediante métodos semiautomáticos e revisados coidadosamente. A partir destes recursos, o equipo puido avaliar o rendemento de numerosos modelos de linguaxe, tanto sen exemplos previos (zero-shot) como dispoñendo dun pequeno número de exemplos de referencia (few-shot).
Cando a proximidade lingüística induce a erros
Os resultados amosan que os grandes modelos de linguaxe progresaron de forma clara durante os últimos anos, especialmente os de maior tamaño. Non obstante, a tarefa continúa sendo especialmente difícil para os modelos máis pequenos, que presentan maiores problemas á hora de diferenciar entre cognatos e falsos amigos.
Un dos resultados máis relevantes da investigación é que, mentres que noutras tarefas de procesamento da linguaxe é a distancia lingüística a que adoita complicar as cousas, aquí sucede o contrario. É xustamente o par máis próximo, galego e portugués, o que máis erros provoca nos modelos, precisamente debido ao elevado solapamento léxico.
«Noutras tarefas», prosegue a investigadora, «unha maior distancia lingüística adoita implicar unha dificultade adicional. Neste caso observamos o efecto contrario: canto menor é esa distancia, maior é o solapamento léxico, e resulta máis difícil determinar se dous termos comparten o mesmo significado. Os modelos grandes presentan unha evolución positiva, pero a ambigüidade segue sendo un desafío, especialmente para os sistemas de menor tamaño».
Ademais de avaliar o comportamento de modelos de última xeración, a investigación pon á disposición da comunidade científica seis novos recursos para estudar a ambigüidade semántica entre galego, portugués e español. A súa publicación pode contribuír ao desenvolvemento de sistemas de tradución automática, asistentes conversacionais e outras aplicacións multilingües capaces de interpretar con maior precisión linguas estreitamente relacionadas.